ROBOT LEARNING / RESEARCH PORTFOLIO

让机器人预见、
记住,并行动.

我是郭赫天,吉林大学人工智能博士生。我的研究聚焦视觉语言动作策略学习、预测式世界模型、视觉触觉操控与全身动作生成,并在双足人形、轮式及双臂平台上开展真机验证。

VLAWORLD MODELS
REAL ROBOTS
PREDICTREMEMBERACT

从潜在状态预测,到跨平台真机验证

RESEARCH / VLA · WORLD MODELS · MOTIONREAL ROBOTS / BIPEDAL · WHEELED · BIMANUALSCROLL ↓

01 / SELECTED WORK

精选研究

从未来状态预测、历史观测记忆到触觉接触动力学与全身动作生成。

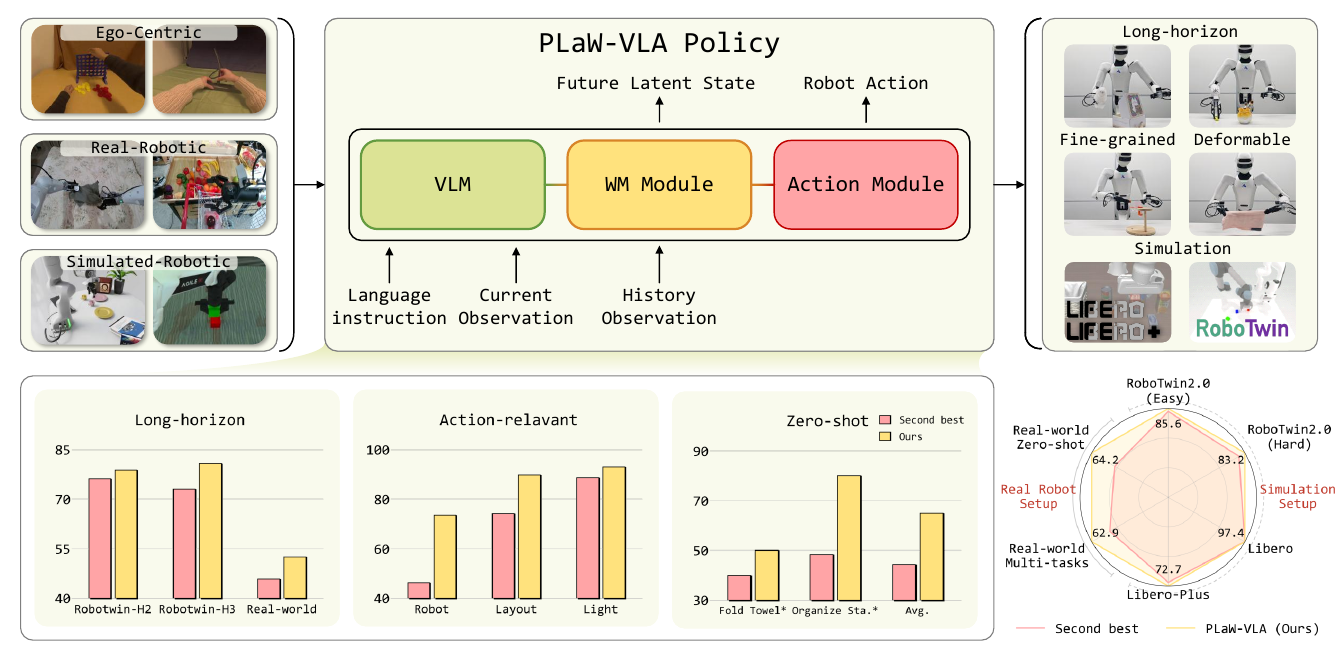
PLaW-VLA Figure 1:潜在世界模型辅助视觉语言动作策略,以及真机与仿真评估概览
FIG. 1 / PLaW-VLA · 点击查看大图
01 / PREDICTIVE WORLD MODELCoRL 2026 · 已接收

PLaW-VLA

PLaW-VLA: Predictive Latent World Modeling for Vision-Language-Action Policies

共同第一作者

在预训练视觉表征空间预测未来状态,而非重建像素,并联合学习状态预测与动作生成;LIBERO / LIBERO-Plus 平均成功率分别为 97.4% / 72.7%,并在 Astribot S1 上验证长程、精细及可变形物体操控。
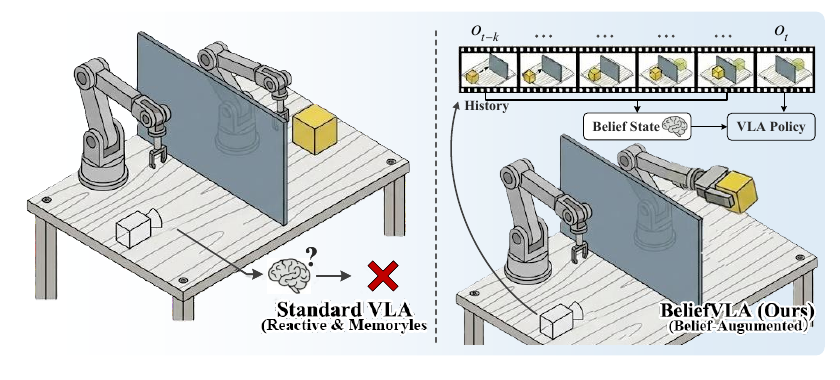
BeliefVLA Figure 1:反应式 VLA 与历史观测驱动的隐式 belief state 策略对比
FIG. 1 / BeliefVLA · 点击查看大图
02 / TEMPORAL BELIEF STATEIROS 2026 · 已接收

BeliefVLA

BeliefVLA: Implicit Belief-State Driven Vision-Language-Action Models for Robust Manipulation

第二作者

从历史观测推断隐式 belief state,为 VLA 注入时序记忆与动力学先验;在 Realman、ARX R5 和 AgileX PIPER 上评估双臂操控与视觉扰动。

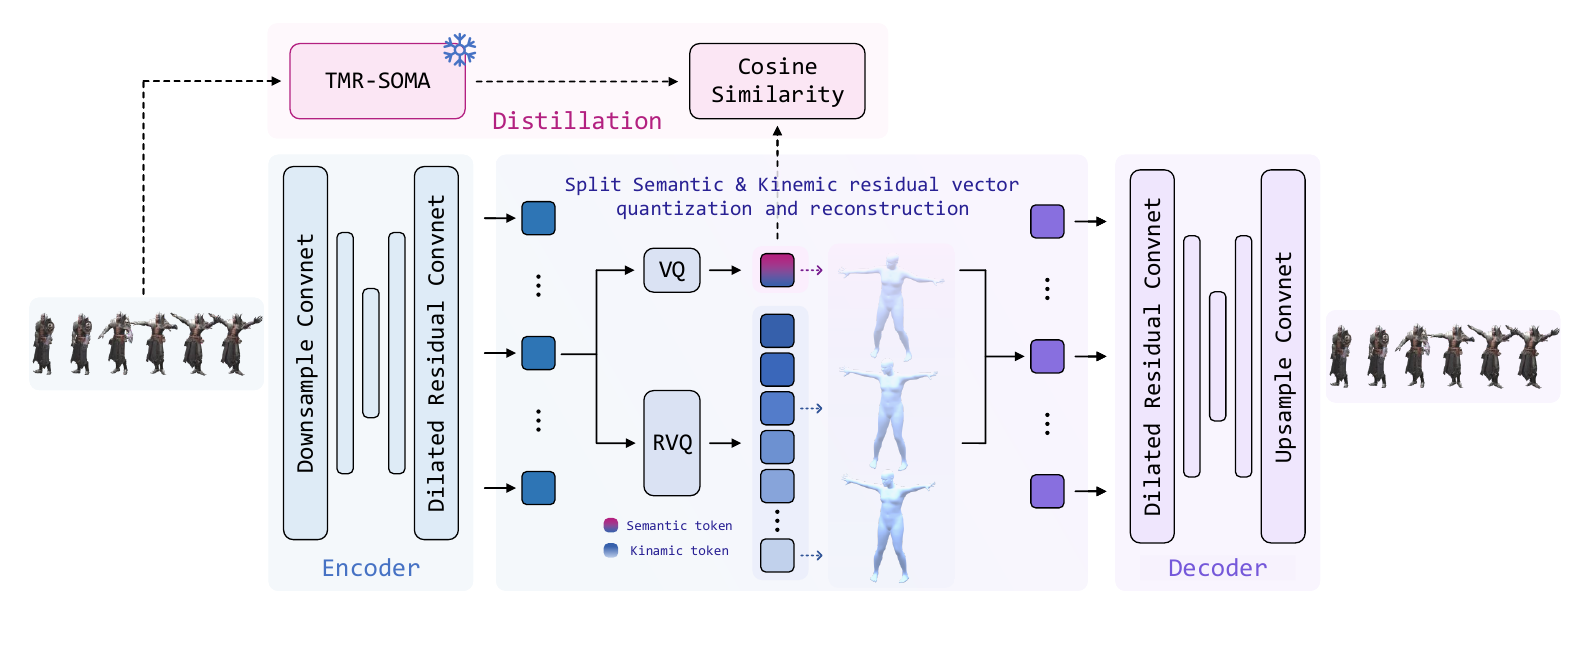
SeMoCo Figure 1:语义 token 与运动学残差分离的动作编码器和解码器
FIG. 1 / SeMoCo · 点击查看大图
03 / MOTION GENERATION

SeMoCo

SeMoCo: A Semantic-First Motion Codec for Motion Language Modeling

共同第一作者

以独立的语义 VQ 和运动学残差 RVQ 构建分层动作 token;双轴生成器沿时间建模语义、在 token 内细化动作。构建统一骨架的 Ω-MotionVerse 数据集,生成动作经 Sonic 在 G1 真机回放。

04 / CONTACT DYNAMICS

TacDyn-WAM

TacDyn-WAM: Learning Implicit Tactile Dynamics in a Heterogeneous Visuo-Tactile World Action Model

合作研究

学习动态感知的触觉目标空间,在多个时间尺度预测接触演化,并让视觉与触觉专家联合建模动作;UniVTAC 平均成功率 81.5%,另有真机验证。

02 / REAL ROBOTS

真机平台与任务

从双足人形到轮式移动平台,再到跨平台双臂操控。

01 / BIPEDAL HUMANOID

双足人形 · Unitree G1

Sonic 动作执行、Inspire 灵巧手集成、多任务真机数据采集与 SeMoCo 生成动作回放。

02 / WHEELED PLATFORMS

轮式平台 · Realman / Astribot S1

在 Realman 上开展 BeliefVLA 扰动测试;在 Astribot S1 上验证 PLaW-VLA 的长程与精细操控。

03 / BIMANUAL MANIPULATION

双臂操控 · Realman / ARX R5

围绕 BeliefVLA 开展跨平台双臂任务,检验历史观测与隐式 belief state 对鲁棒控制的作用。

03 / BACKGROUND

经历

目前在吉林大学攻读人工智能博士;研究覆盖机器人学习与时空建模。

研究与实习

AI 算法实习生 · 道和通泰机器人

在宇树 G1 部署 Sonic、GMR + AMO 动作链路并接入 Inspire 灵巧手;采集多任务真机遥操作数据,微调和部署 Psi-0、GR00T N1.7。开展 SeMoCo 全身动作生成研究(投稿 AAAI 2027),将生成动作经 Sonic 在 G1 回放。

研究实习生 · LocationMind

研究北海与波罗的海 AIS 航迹的航路网络提取、趋势与周期分解,以及静态和动态空间关系建模;参与构建海事交通流预测模型,成果发表于 Transportation Research Part E(2025)。

教育

吉林大学

工学博士 · 人工智能
研究方向:具身智能、VLA、世界动作模型与灵巧手控制;导师:范子沛教授

佐治亚大学

理学硕士 · 工程学(机械工程方向)
研究方向:智能交通系统、自动驾驶与软硬件联合仿真;导师:Yunli Shao 教授

南方科技大学

工学学士 · 计算机科学与技术
研究方向:智能交通系统、时空数据挖掘与交通预测;导师:宋轩教授

04 / INTELLIGENT TRANSPORTATION SYSTEMS

ITS · 智能交通系统研究

早期工作围绕交通参与者轨迹预测和海事交通流时空建模。

2024 / ICRA

HHGNN: Heterogeneous Hypergraph Neural Network for Traffic Agents Trajectory Prediction in Grouping Scenarios

第一作者 · 分组交通场景中的异质高阶交互与轨迹预测

2025 / TRANSPORTATION RESEARCH PART E

A Decomposable Multi-Fusion Spatio-Temporal Marine Traffic Flow Forecasting Algorithm: Taking the North Sea and Baltic Sea Region as an Example

第二作者 · 北海与波罗的海 AIS 航路网络与交通流预测;LocationMind 实习研究成果

05 / RESEARCH & ENGINEERING

研究与工程能力

以已完成的论文和真机实验为依据,区分方法研究、系统实践与软件实现。

研究方法

VLA / 世界动作模型、预测式潜在状态、视觉触觉表征、语言条件全身动作生成与策略微调。

真机系统

双足人形、轮式与双臂平台的操控实验,多任务遥操作数据采集、动作工作流部署与回放。

软件实现

使用 Python / PyTorch 构建模型训练与评估流程,以 C++、ROS / ROS2 对接机器人控制;使用 Transformers、Diffusers 开展生成模型实验。

06 / CONTACT

一起研究下一步
机器人能做什么。

机器人学习、VLA、世界模型或研究实习机会,欢迎联系。